NouveauLe guide : 11 exemples de paywall

MéthodeNotre méthode CRO en 7 étapes pour les apps mobiles.

Le CRO consiste à améliorer le parcours qui mène à une action utile ou à un achat. On part des données, on formule une hypothèse, puis on compare les résultats sur une période définie. Le but : prendre une décision que les chiffres permettent de défendre.

Revenu quotidien d'une app, avant et après firstapp

Revenu quotidien : une évolution à relire avec le trafic, les campagnes et les changements du produit.

Avant de commencer

Deux erreurs qui coûtent cher à votre app.

  1. 01

    Tester sans hypothèse.

    Un concurrent change son paywall, on le copie. La conversion baisse, on modifie le prix. On multiplie les changements sans avoir identifié le problème à résoudre.

  2. 02

    Changer sans comprendre.

    Nouveau paywall, nouveau pricing, nouvel onboarding. Les revenus évoluent, mais impossible de savoir précisément pourquoi. On avance sans apprendre.

Le but n'est pas de multiplier les tests. C'est d'apprendre plus vite ce qui augmente réellement vos revenus.

Notre approche

Chaque expérimentation répond à une question précise.

Une expérimentation relie un constat à une décision : qui rencontre le problème, quel changement pourrait aider, et quelle mesure permettrait de le vérifier. Les retours utilisateurs aident à expliquer les chiffres.

Onboarding, pricing, offres, paywalls, rétention : chaque étape du parcours peut devenir une opportunité d'amélioration.

Notre cycle d'expérimentation

  1. Observer
  2. Comprendre
  3. Formuler
  4. Tester
  5. Mesurer
  6. Apprendre

Un test mesure un effet dans un contexte donné. Les observations et les retours utilisateurs aident ensuite à comprendre le mécanisme possible.

La boucle

Sept temps. Puis on recommence.

Du diagnostic à la décision, chaque étape produit un livrable. Le volume disponible et le cycle du produit déterminent ce qu’on peut apprendre.

01

Lire.

Avant de tester, on doit voir ce qui se passe.

Notre checklist d’audit de monétisation détaille les données à réunir et les vérifications à effectuer. Pour faire examiner ce parcours avec firstapp, l’audit de monétisation livre un diagnostic et cinq priorités.

On lit dans l'outil déjà en place. Amplitude, PostHog, pour le parcours. RevenueCat, Adapty, pour le revenu.

Le funnel décrit les étapes du parcours. On vérifie les événements, les doublons et la correspondance entre achats et revenus. Puis on compare des groupes définis : pays, plateforme, source ou date d’arrivée, selon la question.

  1. Installation
  2. Onboarding commencé
  3. Onboarding fini
  4. Paywall vu
  5. Essai commencé
  6. Abonnement
  7. Renouvellement

Pour chaque taux, on précise le numérateur, le dénominateur et la période. Une différence entre trafic publicitaire et organique peut venir de l’audience, de l’intention ou du parcours : elle ne désigne pas seule la cause.

On relit les tests déjà faits et on corrige les événements manquants avant de comparer. L’objectif est de distinguer une évolution réelle du produit d’une évolution de sa mesure.

02

Nommer le problème.

Une métrique dit où regarder. Elle ne dit pas pourquoi.

Une faible exposition au paywall peut venir d’un abandon précoce, d’un ciblage volontaire ou d’un problème de mesure. On distingue le constat des explications possibles avant de déplacer l’offre.

On croise le chiffre avec les avis, les tickets, les raisons d'annulation, les sessions, et ce que disent les utilisateurs des apps d'à côté. On cherche le travail qu'ils veulent faire, ce qui les a fait essayer, ce qui les retient, les mots qu'ils utilisent. Ces mots servent ensuite au texte de l'onboarding et du paywall.

On regarde les parcours des apps qui marchent dans la catégorie, pour voir les motifs. On ne copie pas leur écran.

Constat : les abandons se concentrent sur la création de compte. Hypothèse à vérifier : cette demande arrive avant que la personne ait compris la valeur du produit.

03

Écrire l'hypothèse.

On écrit toujours de la même façon.

Pour [cette population], [ce changement] devrait améliorer [cette mesure], parce que [ce mécanisme]. On l’observe pendant [cette durée], sans dégrader [ces garde-fous].

Exemple : déplacer le compte après un premier résultat utile pourrait améliorer l’activation des nouveaux utilisateurs. On vérifie aussi que la sauvegarde des données et le passage vers l’offre restent satisfaisants.

La différence est entière. On ne teste pas « un nouvel onboarding ». On teste l'idée qu'une friction précise bloque l'activation.

L'hypothèse, la métrique principale, les métriques secondaires et les garde-fous sont écrits avant qu'on dessine. Sinon, le résultat se lit après coup, dans le sens qu'on espérait.

04

Choisir.

Une équipe a vite trente ou cinquante idées. Elle ne peut pas les lancer toutes.

Un score aide à comparer les idées : impact estimé × confiance / effort. C’est un outil de discussion, pas une mesure objective du futur gain.

L'impact : si l'hypothèse est juste, qu'est-ce que ça change sur le revenu. La confiance : qu'est-ce qui la soutient déjà, dans vos chiffres et dans ce qu'on a entendu. L'effort : le temps pour concevoir, développer, mettre en ligne.

Ça évite trois semaines sur un test dont l'effet possible est mince, pendant qu'un autre part en deux jours.

La priorité dépend du problème observé, du coût du test et du volume nécessaire. Des tests simultanés demandent un plan qui tient compte de leurs interactions ; sinon, on les sépare.

05

Construire le test.

Un test est défini avant d'être développé.

Le contrôle est l’expérience de référence ; la variante est le changement évalué. Les personnes éligibles sont réparties aléatoirement entre les deux. On définit la métrique principale, les mesures complémentaires et les limites acceptables : remboursements, activation ou renouvellement.

Pour un test d’offre : comparer le revenu après remboursements à J30 par personne assignée. Les essais et les achats aident à lire le résultat ; les remboursements et l’usage du produit servent de garde-fous.

Un changement isolé aide à interpréter le mécanisme. Un redesign testé aléatoirement peut mesurer l’effet de l’ensemble ; il ne permet pas de répartir cet effet entre le texte, le prix et la mise en page.

Chaque personne garde sa variante. On vérifie que la répartition observée correspond à celle prévue, ainsi que les erreurs techniques et l’exposition réelle. L’analyse principale conserve les personnes dans leur groupe d’assignation, selon le protocole prévu.

On distingue la durée d’inclusion et le suivi de chaque personne. Pour un revenu à J30, il faut attendre trente jours après la dernière inclusion. Le volume visé, les cycles d’usage et la règle d’arrêt sont définis avant le lancement ; une lecture anticipée demande une méthode adaptée.

On estime le volume nécessaire à partir du taux initial, de l’écart utile à détecter et de la variabilité. Si ce volume n’est pas accessible, on peut commencer par des entretiens ou une analyse de parcours, puis documenter les limites de la comparaison.

06

Lire le revenu.

Un test de paywall ne se juge pas sur le paywall.

Un taux d’essai plus élevé peut accompagner moins de paiements, ou un revenu plus faible. On suit le parcours jusqu’à l’échéance choisie pour comprendre ce qui a changé.

  1. Paywall vu
  2. Essai
  3. Essai vers payant
  4. Revenu par installation
  5. Valeur dans le temps

Chaque mesure a son dénominateur et son horizon. L’ARPU est un revenu moyen par utilisateur sur une période définie. Une LTV projetée estime la valeur future ; elle reste distincte du revenu déjà observé.

  1. 01
    Le taux d'essai. Essais démarrés rapportés aux personnes éligibles définies dans le protocole.
  2. 02
    Le trial-to-paid. Essais devenus payants rapportés aux essais suffisamment suivis. Il aide à comprendre le passage au paiement.
  3. 03
    Le revenu observé à J30. Revenu après remboursements, avant commissions des stores, par personne assignée. Chaque groupe a la même durée de suivi.
  4. 04
    Les renouvellements et le revenu plus loin. Un premier paiement ne mesure pas les cycles suivants. On choisit une échéance adaptée à la durée des plans.

La décision suit la métrique choisie au départ et les garde-fous. Une baisse du passage au payant peut avoir plusieurs causes ; on examine les données avant de l’attribuer à la promesse du paywall.

On prépare les segments importants avant le test. Les écarts découverts après coup, par pays ou par canal, servent de pistes à vérifier : multiplier les découpages augmente le risque de conclusions fragiles.

Un test aléatoire mené en parallèle aide à comparer des groupes exposés au même contexte. On documente aussi les campagnes, mises en avant et incidents ; une simple comparaison avant/après isole moins bien leur effet.

Résultat d'un test : la variante firstapp contre le contrôle, sur la LTV et le MRR

Comparaison du contrôle et de la variante dans RevenueCat : revenu réalisé, valeur par client payant et revenu mensuel récurrent.

07

Garder, ou laisser.

Le bilan relie l’effet mesuré à la décision : ampleur, incertitude, garde-fous et conditions de mise en œuvre.

  • Il gagne.

    L’effet est suffisamment étayé, utile et compatible avec les garde-fous. On déploie selon le risque, puis on surveille le résultat.

  • Il perd.

    Les données indiquent une dégradation suffisamment étayée. On garde le contrôle et on documente ce que le test permet de conclure.

  • Il ne tranche pas.

    L’incertitude reste trop large, ou l’écart est trop faible pour décider. On garde ce statut sans le transformer en égalité entre les variantes.

Quand le volume et le risque le justifient, un groupe témoin peut rester sur la référence pour vérifier la tenue des gains dans le temps.

Les surfaces

Sept endroits. Chacun a sa métrique.

Chaque test a ses garde-fous, pour qu'un gain ici ne fabrique pas une perte plus loin. L'optimisation ne s'arrête pas au premier paiement.

01

La fiche store · ASO.

La fiche est la première conversion. On teste l'icône, l'ordre des captures, le message, la proposition, la langue, les pages produit.

MétriqueDe l'impression à la visite, puis à l'installation.

02

L’onboarding.

Il transforme une installation en compréhension, puis en activation. Pour beaucoup d'apps à abonnement, l'essai se joue le premier jour, souvent dans la première session. On teste le nombre d'écrans, l'ordre, le quiz, la personnalisation, le moment du compte, le moment où l'app devient claire, le moment du paywall.

MétriqueFin d'onboarding. Installation vers paywall vu. Installation vers essai.

03

Le moment du paywall.

Quand et où on le montre pèse autant que ce qu'il contient. Fin d'onboarding, début, fonction verrouillée, limite d'usage, après une action.

MétriquePart des installations qui voient le paywall. Conversion selon l'endroit.

04

L'offre et le prix.

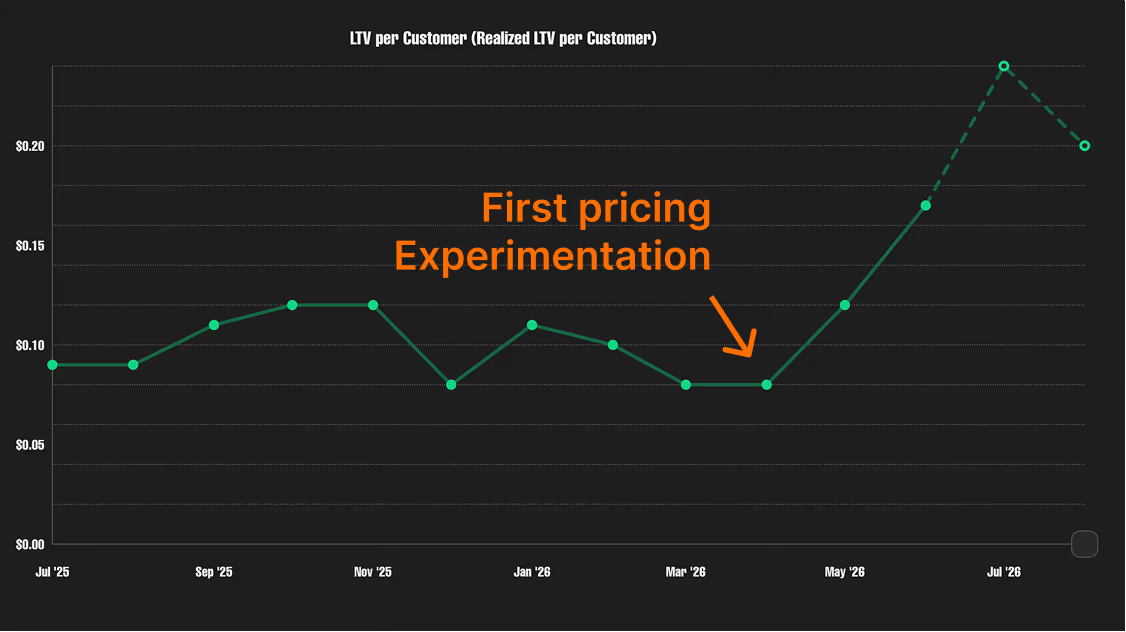
Durée d'essai, ou pas d'essai. Mensuel, annuel, à vie. Le prix. Le prix par pays. Une offre d'entrée. Un bundle. C'est souvent le plus gros levier, et le plus lent, parce qu'un prix passe par les stores. Une hausse de prix peut baisser la conversion et monter le revenu. On juge le revenu et la valeur dans le temps, pas le taux seul.

MétriqueARPU. Mélange des plans. LTV.

LTV par client, avant et après le premier test de prix

Évolution de la LTV par client autour d’un changement de prix.

05

L'écran.

La façon dont l'offre est lue avant même le texte. Un écran ou plusieurs. Le défilement ou le pli. La hiérarchie du prix et du bouton. La preuve à côté de la décision. Le paiement dans l'app ou sur le web, quand c'est le sujet.

MétriquePaywall vu, puis essai, puis achat.

06

Après l'achat.

Beaucoup d'apps posent la personne dans le produit à la seconde où elle a payé. On dessine ce qui suit : confirmation, calendrier de l'essai, première action qui rend l'achat concret.

MétriqueTrial-to-paid. Remboursements. Annulations du premier jour.

07

La rétention.

La boucle qui fait revenir. Les notifications, le rappel de la valeur, le parcours d'annulation, l'offre pour rester, le retour de ceux qui sont partis. Une personne qui résilie donne la prochaine hypothèse, si on lui demande pourquoi.

MétriqueRetour à une action utile. Renouvellement à échéance. Churn sur une période définie.

Le paywall

On ne commence pas par le visuel.

L'offre d'abord. Le détail du bouton, seulement là où les vues sont nombreuses.

01

L'offre.

Annuel seul, ou mensuel et annuel. Trois jours, sept jours, quatorze, ou pas d'essai. Essai gratuit, ou un premier prix bas. Le prix lui-même.

02

La promesse.

Le résultat, ou la fonction. Une ligne, ou trois. Une phrase qui reprend la réponse donnée dans l'onboarding.

03

La preuve.

La note et le nombre d'avis près du bouton. Une citation. Un logo, quand il est vrai. Un volume d'usage, quand le chiffre est le vôtre.

04

Le bouton.

Le bouton décrit l’action réelle : démarrer un essai ou acheter. Le montant, la périodicité et les conditions après l’essai restent compréhensibles pendant toute la comparaison.

05

La mise en page.

Long écran, ou un seul pli. Plusieurs étapes, ou une. Un visuel animé, ou fixe. Un paywall en plusieurs étapes aide souvent un trafic froid, et peut gêner quelqu'un qui connaît déjà l'app.

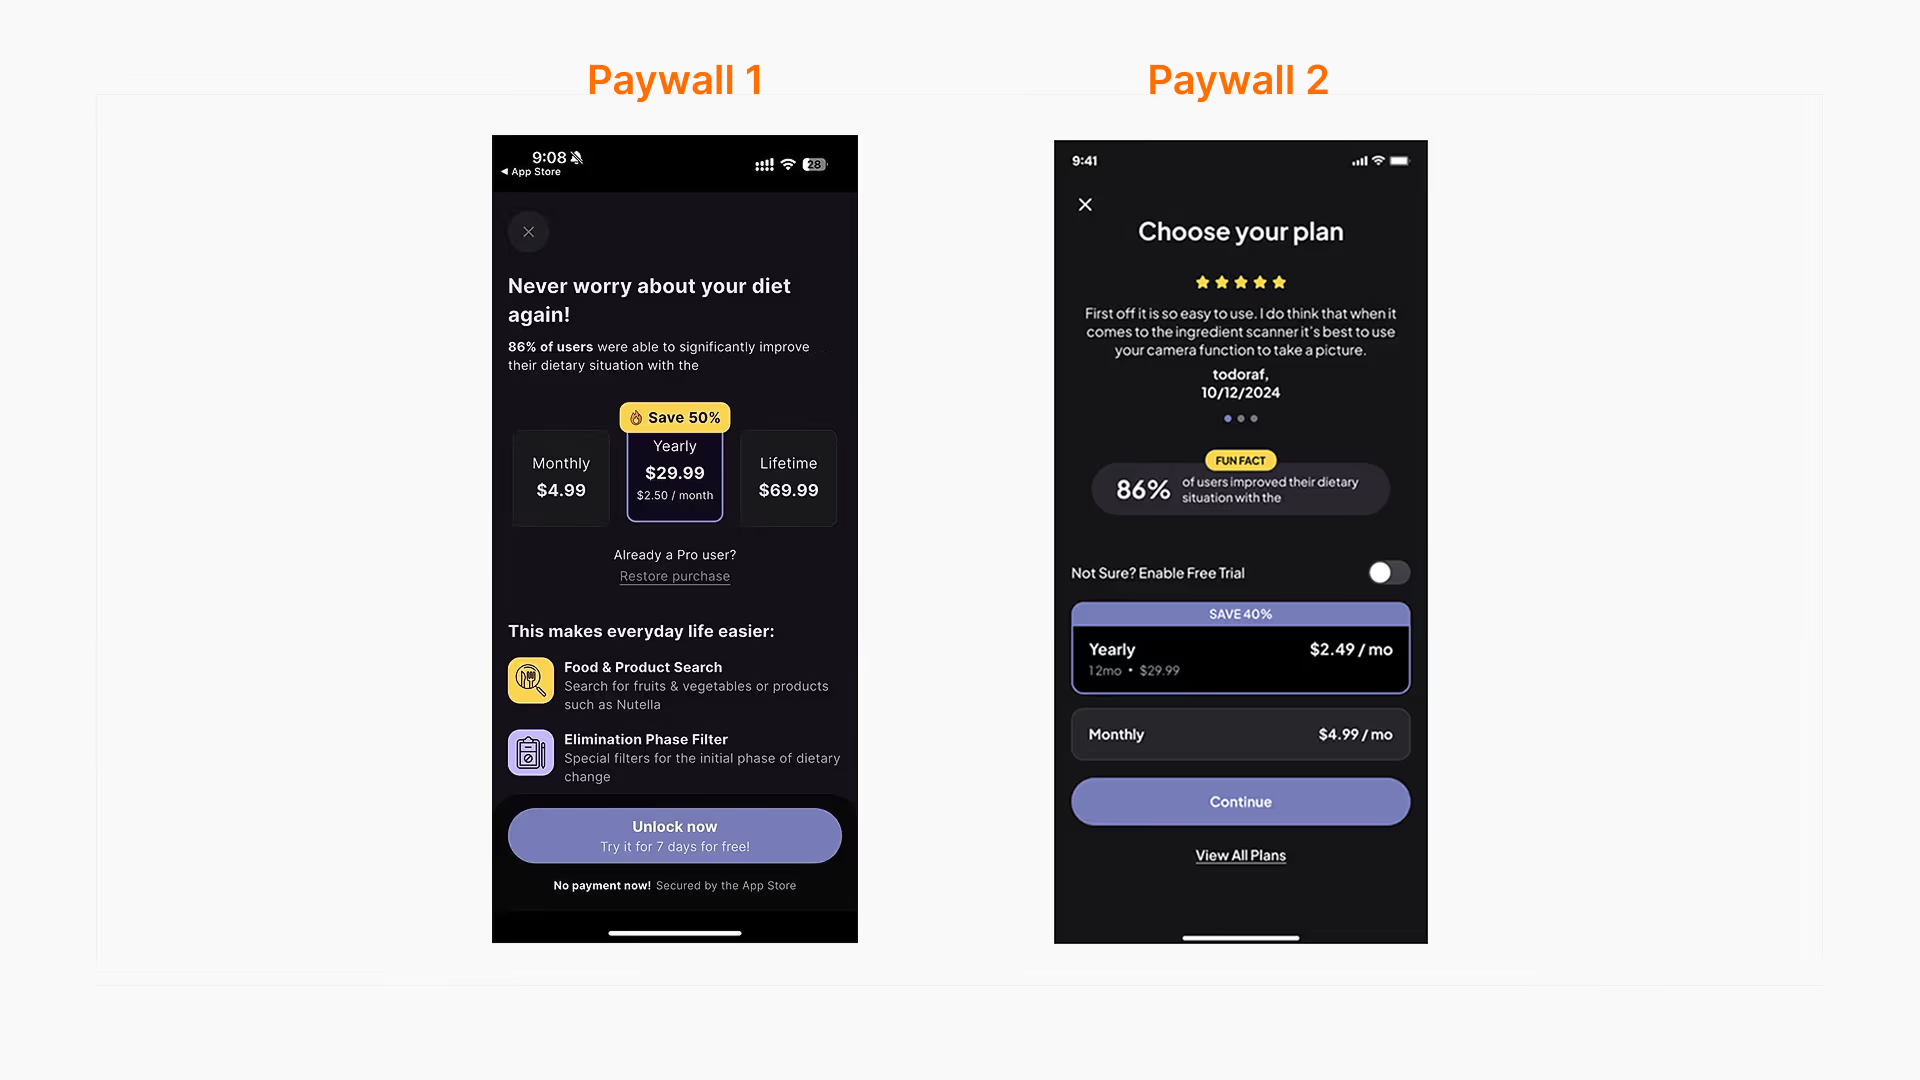
Deux paywalls testés côte à côte, offre, preuve et bouton

Deux variantes de paywall : plusieurs éléments changent, le test évalue l’ensemble de la présentation.

La couleur, le rayon, le dégradé : seulement là où les vues sont nombreuses. Sur une petite app, ce test ne paie pas le temps qu'il prend. Les écrans ouverts suivent le même ordre.

Avant de lancer

Ce qu'on coupe.

  1. La confirmation.

    On croit que B va gagner, et chaque signal va dans ce sens.

    L'hypothèse et le seuil sont écrits avant.

  2. Le concurrent.

    On a vu un écran ailleurs, on suppose qu'il marche.

    On part de vos chiffres et de vos utilisateurs.

  3. Le test multiple.

    Cinq variables en même temps, lues comme une seule cause.

    Distinguer l’effet d’un changement isolé de celui d’un ensemble testé en parallèle.

  4. La métrique facile.

    On optimise ce qui monte vite.

    Une métrique principale. Des garde-fous liés au revenu, au renouvellement, à la rétention.

  5. La lecture trop tôt.

    On coupe parce que la courbe a l'air bonne.

    Le calendrier et la règle d’arrêt sont fixés avant. Une lecture séquentielle demande une méthode adaptée.

À vous

Ce que vous gardez.

Quand la mission s'arrête, la liste, les briefs et les lectures restent à vous.

  • 01
    La liste des tests.

    Ordonnée avec l’hypothèse, les éléments qui la soutiennent et l’effort estimé. Les scores restent discutables et révisables.

  • 02
    Un brief par test.

    Population, contrôle, variante, métrique, garde-fous, volume visé et durée de suivi. La décision attendue est écrite avant le lancement.

  • 03
    Une lecture à la fin.

    L’effet estimé, son incertitude et la décision. Les limites sont documentées avec les résultats pour guider le prochain test.

La vitesse

Hypothèses. Exécution. Mesure.

De bonnes hypothèses, et trois semaines pour lancer chaque test : on apprend lentement. Une exécution rapide, et des tests au hasard : beaucoup de bruit. De bonnes hypothèses, une exécution rapide, et un tracking troué : on ne sait pas ce qui a marché.

Les trois tiennent ensemble. Une roadmap répond à deux questions. Qu'est-ce qu'on construit. Qu'est-ce qu'on va apprendre.

Les questions fréquentes

Par où vous commencez ?

Par la fiabilité des données et le parcours utilisateur. On vérifie les événements et les populations, puis on cherche une friction avec un enjeu pour le produit. La plus grosse baisse entre deux écrans n’est pas automatiquement la meilleure priorité.

Faut-il beaucoup d'utilisateurs ?

Le volume nécessaire dépend du taux initial, de l’écart utile à détecter et de la variabilité de la mesure. Avec peu de trafic, on peut privilégier des entretiens, une analyse de parcours ou un changement ciblé. Un écart observé sur quelques achats reste incertain.

Combien de temps dure un test ?

On distingue la période d’entrée dans le test et la durée de suivi de chaque personne. Pour un revenu à J30, les dernières personnes incluses doivent aussi être suivies trente jours. Le calendrier dépend du volume, de l’essai et du cycle de renouvellement ; il est cadré avant le lancement.

Vous ne changez qu'une chose ?

Un changement isolé aide à comprendre son rôle. Un redesign peut aussi être comparé au contrôle dans un test aléatoire : on mesure alors l’effet de l’ensemble, sans attribuer le résultat à un élément précis.

Quelle métrique décide ?

La métrique principale dépend de l’hypothèse : activation, achat ou revenu sur une période définie. On la lit avec les garde-fous. Le passage de l’essai au payant aide à expliquer un résultat, mais ne suffit pas à identifier sa cause. Une LTV projetée reste distincte du revenu déjà observé.

Comment vous savez qu'une variante a gagné ?

On compare l’effet estimé, son incertitude et son intérêt économique, avec une méthode choisie avant le lancement. Un test de Fisher peut comparer deux taux, mais une p-value n’est pas la probabilité que l’hypothèse soit vraie. Un résultat peut être favorable, défavorable ou encore indéterminé.

Quelle différence avec Growth ?

Growth, c'est travailler la monétisation avec l'équipe qui a construit l'app. Cette page, c'est la méthode qu'on applique, sur Growth comme sur une app qu'on a faite.

Qu'est-ce qu'on garde à la fin ?

Une liste priorisée, un brief par test et un bilan : population, durée, résultat, incertitude et décision. Les tests non concluants sont documentés comme les gains et les pertes, pour garder une trace réutilisable.

Si
est unique,
écrivez-nous.

Newsletter

Une fois par semaine.

La dernière envoyée

On a ouvert 10 apps pour voir comment elles nous vendent un abonnement.

+534 personnes nous lisent chaque semaine